

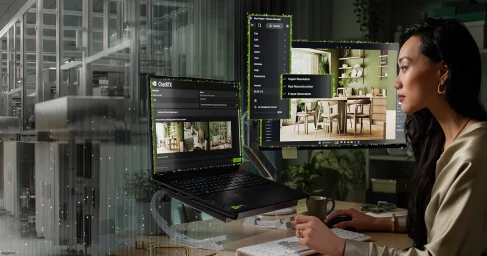


NVIDIA ChatRTX — локальный RAG-ассистент для Windows-компьютеров с совместимой RTX-видеокартой. Его задача — не конкурировать с облачными чат-ботами по числу функций, а показать, как языковая модель может отвечать на вопросы по вашим собственным документам непосредственно на ПК. Пользователь указывает папку с файлами, ChatRTX индексирует материалы, находит подходящие фрагменты и передаёт их локальной LLM как контекст.
Какие данные можно подключить
Официальная страница перечисляет текстовые файлы, PDF, DOC/DOCX и XML. Папку можно использовать как небольшую личную базу знаний: инструкции, заметки, проектную документацию или архив отчётов. После индексации запрос формулируется обычным языком, а модель пытается ответить с опорой на найденные фрагменты.
RAG особенно полезен тогда, когда вопрос касается фактов, которых не было в обучении базовой модели. При этом система не превращает неструктурированный архив в безошибочную базу: плохой OCR, неоднозначные названия файлов и противоречащие друг другу документы всё ещё влияют на качество ответа.
Главное преимущество — локальная обработка
ChatRTX работает на самом ПК, поэтому исходная папка с документами не должна отправляться в облачный LLM-сервис для каждого вопроса. Это удобно для черновой работы с внутренними материалами и ситуаций, когда не хочется загружать документы в сторонний аккаунт.
Локальность не отменяет обычную безопасность компьютера. Если Windows-аккаунт скомпрометирован или папка доступна другим пользователям, ChatRTX не является отдельной системой защиты документов.
Системные требования и ограничения VRAM
Текущая официальная страница ChatRTX указывает Windows 11, не менее 16 ГБ оперативной памяти и NVIDIA GeForce RTX 30/40 Series либо RTX Ampere/Ada с минимум 8 ГБ VRAM; также требуется подходящий драйвер. Размер установки большой, поскольку вместе с приложением используются локальные модели и зависимости.
Для локальной LLM именно VRAM часто становится главным ограничением. Если модель почти полностью занимает память GPU, параллельные задачи и большие контексты могут заметно снизить скорость. Перед установкой на рабочую машину стоит оставить запас диска и видеопамяти.
Как устроен RAG в ChatRTX
Приложение использует retrieval-augmented generation и ускорение TensorRT-LLM. Сначала запрос применяется для поиска релевантных частей локального набора, затем эти части добавляются к контексту языковой модели. Поэтому качество зависит сразу от двух этапов: насколько хорошо найден нужный документ и насколько корректно модель интерпретировала найденный текст.
Для точных задач полезно задавать вопрос с конкретными терминами из документа и просить назвать источник или фрагмент, на котором построен ответ. Важные цифры всё равно следует сверять с исходным файлом.
ChatRTX как демонстрация для разработчиков
NVIDIA прямо называет продукт tech demo. Он построен на референсном TensorRT-LLM RAG-проекте, поэтому интересен не только конечному пользователю, но и разработчику, который хочет понять архитектуру локального поиска по документам на RTX. Для собственного продукта лучше использовать соответствующие developer-инструменты и самостоятельно задавать политику индексации, интерфейс и источники данных.
Когда выбирать ChatRTX, а когда облачный чат
ChatRTX разумен для локального архива и экспериментов с RAG без отдельной серверной инфраструктуры. Облачные ассистенты обычно удобнее, если нужны веб-поиск, синхронизация между устройствами, совместная работа и самые новые крупные модели. Здесь выбор определяется не «какой чат умнее», а тем, где должны находиться данные и какой GPU уже есть в компьютере.
Стоимость и ограничения
Приложение распространяется бесплатно, подписка не нужна. Фактическая цена — совместимый RTX-компьютер и локальные ресурсы. Русский язык определяется выбранной моделью, а не отдельным русским интерфейсом ChatRTX, поэтому перед использованием стоит прогнать несколько реальных документов на русском и проверить качество поиска, склонения терминов и длинных ответов.
ChatRTX — демонстрация локального RAG, а не облачный конкурент ChatGPT
ChatRTX построен вокруг простой идеи: пользователь указывает папку со своими файлами, приложение индексирует их и отвечает с опорой на локальную библиотеку. RAG позволяет не «обучать модель на документах», а находить релевантные фрагменты и передавать их LLM в момент вопроса. Это удобный способ понять архитектуру корпоративного ассистента без самостоятельной сборки vector database и inference-сервера.
Главное отличие от облачного чата — данные и модель работают на Windows-компьютере с RTX. Это снижает необходимость отправлять документы во внешний API, хотя пользователь всё равно должен учитывать безопасность самого компьютера, резервные копии и права доступа к папкам.
Какие файлы имеет смысл индексировать
Официально приложение поддерживает текстовые документы, PDF, DOC/DOCX и XML. Лучше создавать тематические папки и не смешивать тысячи нерелевантных файлов. Если база содержит несколько версий одной инструкции, RAG может найти устаревший вариант и сформировать уверенный, но неверный ответ.
Перед индексацией полезно удалить дубликаты и пометить актуальные документы понятными именами. Для договоров и регламентов особенно важно хранить дату версии внутри файла.
Почему ChatRTX подходит не каждому ПК
NVIDIA указывает Windows 11, GeForce RTX 30/40 или профессиональную RTX на Ampere/Ada с минимум 8 ГБ VRAM, не менее 16 ГБ системной памяти и совместимый драйвер. Дистрибутив и модели занимают десятки гигабайт, поэтому нужен запас SSD. Эти требования означают, что ChatRTX — не универсальное приложение для любого ноутбука.
Если видеопамяти мало, размер и скорость доступных моделей ограничиваются. Для более тяжёлой локальной системы разработчику может быть выгоднее перейти от demo-приложения к собственной сборке на TensorRT-LLM.
Почему ответы по документам всё равно нужно проверять
RAG уменьшает галлюцинации, но не устраняет их. Модель может неверно объединить два фрагмента, пропустить исключение или ответить по похожему документу. Для юридических, финансовых и технических инструкций полезно просить ссылку на источник и открывать сам фрагмент перед действием.
Если ответ критичен, ChatRTX стоит использовать как поиск и черновой анализ, а не как систему принятия решения.
Что получает разработчик
ChatRTX основан на developer reference-проекте TensorRT-LLM RAG. Поэтому интересен не только как конечное приложение: архитектуру можно использовать как ориентир для собственного локального ассистента. В custom-проекте разработчик уже сам выбирает embedding, chunking, интерфейс, модель и правила доступа.
Когда лучше облачный сервис
Локальный режим выигрывает в приватности и отсутствии оплаты за каждый токен, но требует RTX и ограничен ресурсами одного компьютера. Облако удобнее для очень больших моделей, командного доступа и мобильной работы. Если ассистент нужен одному сотруднику на рабочей станции и работает с закрытыми файлами, ChatRTX выглядит логично; если нужен сотням пользователей, потребуется другая архитектура.
