
Почему нейросети рисуют по-разному и как выбрать генератор изображений

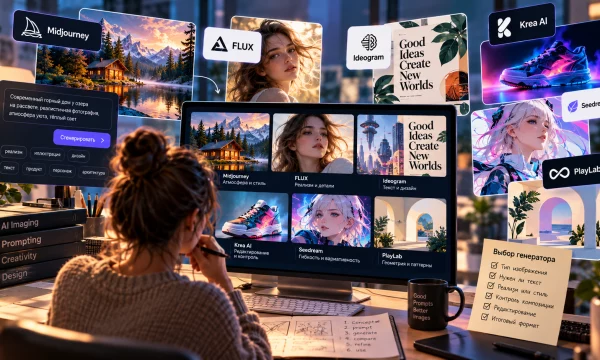
Один и тот же текстовый запрос можно отправить в несколько генераторов изображений и получить результаты, которые почти не похожи друг на друга. Одна нейросеть сделает эффектную журнальную картинку, другая постарается буквально выполнить каждое условие, третья лучше справится с надписями, а четвёртая окажется удобнее не для первоначальной генерации, а для постепенного редактирования уже созданного изображения.
Поэтому вопрос «какая нейросеть рисует лучше» поставлен не совсем правильно. Универсального победителя здесь нет. Гораздо полезнее понять, какой тип изображения требуется получить, насколько важен контроль над композицией и что вы собираетесь делать с результатом после генерации.
Разберём, почему AI-модели обладают разным визуальным характером, где заканчивается влияние хорошего промта и как выбирать генератор не по популярности, а по конкретной задаче.
Почему одинаковый промт не означает одинаковую картинку
Со стороны процесс кажется простым: пользователь вводит текст, нейросеть превращает его в изображение. Из-за этого возникает естественное ожидание, что разные системы должны интерпретировать одинаковый запрос примерно одинаково.
На практике текстовый промт — только одна часть процесса.
Результат зависит от множества факторов:
- архитектуры и поколения модели;
- данных, на которых она обучалась;
- того, какие изображения и описания встречались в обучающей выборке;
- способа обработки текстового запроса;
- внутренних механизмов композиции;
- настроек самого сервиса;
- силы стилизации;
- случайной составляющей генерации;
- дополнительных моделей, используемых для улучшения результата.
Иными словами, когда два генератора получают фразу «небольшой деревянный дом у озера на рассвете», они не ищут одну и ту же фотографию. Каждый строит собственную вероятностную интерпретацию того, как такой сюжет должен выглядеть.
Нейросеть не ищет картинку — она конструирует её
Одна из самых устойчивых ошибок в понимании генеративных моделей заключается в представлении, будто система ищет подходящее изображение среди известных ей фотографий.
Генерация устроена иначе. Модель пытается создать новую визуальную структуру, которая статистически соответствует описанию.
Поэтому в запросе:
Красный спортивный автомобиль на мокрой городской улице ночью, отражения неона, вид немного сверху.
нет готового указания, где именно должна находиться машина, какого размера должны быть фонари и насколько крупным должен быть автомобиль относительно кадра.
Часть этих решений модель принимает самостоятельно.
Именно здесь начинает проявляться её собственный визуальный характер.
У каждой модели есть свои визуальные привычки
Даже когда разработчики стремятся сделать генератор максимально универсальным, некоторые визуальные решения у него получаются легче других.
Одна модель может чаще создавать драматическое освещение и сложную художественную композицию. Другая тяготеет к более буквальному исполнению запроса. Третья лучше работает с рекламным дизайном, где нужно совместить объект, пространство и надпись.
Это не обязательно означает, что одна нейросеть объективно лучше.
Представим две задачи:
- создать фантастический город для обложки книги;
- нарисовать белую кофемашину на светлом фоне для карточки товара.
В первом случае некоторая художественная свобода модели будет преимуществом. Во втором — тот же самый «творческий характер» может только мешать.
Midjourney: когда важна визуальная выразительность
Midjourney долгое время развивался прежде всего как инструмент визуального творчества. Именно поэтому его часто выбирают не для буквального технического воспроизведения объекта, а для поиска выразительного изображения.
Он особенно интересен там, где важны:
- атмосфера;
- свет;
- композиция;
- цвет;
- стилизация;
- общее художественное впечатление.
Это хорошо подходит для концепт-арта, обложек, рекламных идей, иллюстраций, модных съёмок и визуального поиска.
Но такая сила одновременно может стать слабостью.
Если требуется очень строгая предметная композиция, где каждый элемент должен находиться в заранее определённом месте, красивый результат ещё не означает точный результат.
Когда Midjourney особенно полезен
Предположим, дизайнеру нужно найти визуальное направление для сайта нового музыкального фестиваля.
На этом этапе ещё неизвестны точные баннеры, размеры блоков и финальная графика. Нужно понять настроение:
- агрессивный или спокойный визуальный язык;
- холодная или тёплая палитра;
- фотореализм или иллюстрация;
- минимализм или визуальный хаос.
Здесь несколько десятков быстрых концепций могут быть полезнее одного технически идеального изображения.
FLUX: когда важна интерпретация подробного задания
FLUX представляет другой интерес: его удобно использовать для более предметных и подробно сформулированных сцен.
Например, запрос может содержать сразу несколько условий:
Современный домашний кабинет. Белый стол расположен справа от окна. На столе ноутбук и небольшое растение. На заднем плане книжный шкаф. Утренний естественный свет. Камера находится немного выше уровня стола. Реалистичная интерьерная фотография.
В таких задачах становится важна не только красота результата, но и то, сколько условий из запроса модель действительно сохранила.
Именно поэтому при сравнении генераторов полезно оценивать не только итоговую картинку, но и prompt adherence — соответствие результата заданию.
Красивое изображение и точное изображение — не одно и то же
Это один из ключевых принципов работы с генеративной графикой.
Представим, что в запросе указано:
Красное кресло слева, высокий торшер справа, большое окно в центре.
Нейросеть создаёт потрясающий интерьер, но кресло становится зелёным, торшер оказывается слева, а окно исчезает.
Эстетически картинка может быть превосходной.
Формально задача выполнена плохо.
Поэтому выбор модели зависит ещё и от того, что является критерием успеха.
Для художественной иллюстрации это может быть эмоциональное впечатление.
Для карточки товара — сходство с реальным объектом.
Для рекламного баннера — расположение элементов.
Для интерфейса — чистая геометрия.
Для постера — правильная надпись.
Ideogram: когда изображение должно содержать текст
Текст внутри изображений долгое время был одним из наиболее заметных слабых мест генеративной графики.
Модель могла отлично нарисовать упаковку кофе, но вместо названия бренда появлялся набор букв, лишь напоминающий человеческий язык.
Ideogram сделал работу с типографикой одним из центральных направлений своего развития.
Именно поэтому его стоит рассматривать отдельно для:
- афиш;
- постеров;
- обложек;
- упаковки;
- рекламных креативов;
- графики для социальных сетей;
- концепций логотипов;
- изображений с крупным заголовком.
Здесь становится видно, почему нельзя выбирать генератор только по общей «красоте» его галереи.
Если вашей задаче необходима надпись, способность модели работать с буквами важнее многих художественных преимуществ конкурентов.
Почему нейросетям вообще сложно рисовать буквы
Для человека разница между изображением кота и словом «КОТ» очевидна.
Первое — картинка. Второе — последовательность символов с жёсткими правилами.
Для генеративной модели обе вещи существуют внутри визуального пространства.
Если буква немного изменит форму, рисунок всё ещё может выглядеть правдоподобно, но слово станет неправильным.
В обычной иллюстрации небольшая неточность формы может быть незаметна. В слове достаточно одной неправильной буквы, чтобы ошибка стала очевидной.
Именно поэтому текстовые задачи требуют от генератора другого уровня структурной точности.
Krea AI: когда генерация превращается в процесс редактирования
Классический способ работы с нейросетью выглядит так:
промт → ожидание → несколько картинок → новый промт → ещё одна генерация.
Krea AI интересен другой моделью взаимодействия. Здесь генерация теснее соединена с визуальным редактированием и быстрым изменением результата.
Вместо постоянного переписывания промта пользователь может работать с изображением более непосредственно: менять композицию, элементы, стиль и смотреть, как эти изменения отражаются на результате.
Для дизайнера это принципиальная разница.
Промт перестаёт быть единственным способом разговора с моделью.
Почему интерфейс иногда важнее самой модели
При выборе AI-сервиса часто обсуждают только название модели.
Но пользователь взаимодействует не с математической моделью напрямую, а с продуктом вокруг неё.
Один и тот же или близкий класс моделей может ощущаться совершенно по-разному в зависимости от того, какие инструменты предоставляет сервис.
Важны:
- работа с референсами;
- маскирование областей;
- изменение размера холста;
- редактирование отдельных объектов;
- вариации;
- история генераций;
- управление цветом;
- повторное использование изображения;
- апскейл;
- экспорт.
Иногда модель с чуть менее эффектной галереей оказывается намного полезнее в реальной работе просто потому, что позволяет быстрее довести изображение до результата.
OpenArt: когда нужна не одна модель, а рабочая среда
OpenArt представляет ещё один подход: пользователь получает не столько один генератор, сколько набор инструментов для работы с визуальным контентом.
Такой формат полезен, если работа над изображением не заканчивается первой генерацией.
После неё может понадобиться:
- изменить отдельную часть;
- расширить кадр;
- убрать ненужный объект;
- заменить фон;
- увеличить разрешение;
- создать несколько вариантов;
- перенести стиль;
- использовать исходное изображение как референс.
В этом случае правильный вопрос звучит уже не «какая модель рисует красивее», а «в каком инструменте мне будет проще пройти весь путь от идеи до готового изображения».
Seedream и проблема универсальности
Seedream относится к классу моделей, которые стремятся объединить генерацию и редактирование в одном визуальном процессе.
Это важное направление развития генеративной графики.
Первые text-to-image системы воспринимались почти как автоматы: написал запрос — получил картинку.
Современный подход постепенно смещается в сторону полноценной работы с изображением:
создать → изменить → использовать референс → получить варианты → исправить область → продолжить сцену.
То есть нейросеть всё меньше напоминает генератор случайных картинок и всё больше — визуальный редактор нового типа.
Почему референс часто полезнее ещё двадцати слов в промте
Предположим, пользователь хочет изображение в определённой композиции.
Можно долго описывать:
Главный объект находится примерно на трети ширины кадра слева, занимает половину высоты, справа большое свободное пространство, камера немного сверху...
Но если сервис поддерживает изображение-референс, простой эскиз иногда передаст эту информацию гораздо точнее.
Даже грубый рисунок из прямоугольников способен объяснить модели пространственную структуру лучше длинного абзаца.
Отсюда следует практический вывод:
хорошая работа с нейросетью — это не искусство писать бесконечно длинные промты. Это умение выбрать наиболее подходящий способ передать модели информацию.
Промт не должен быть литературным произведением
Существует популярный миф о «магических промтах» — длинных конструкциях из десятков эпитетов, технических терминов и указаний камеры.
Иногда подробность действительно помогает. Но количество слов само по себе не делает запрос хорошим.
Промт должен прежде всего уменьшать неоднозначность.
Полезная структура выглядит примерно так:
объект → действие → окружение → композиция → освещение → визуальный тип → ограничения.
Например:
Жёлтая настольная лампа на деревянном столе. Лампа находится слева от центра, справа свободное пространство. Тёмная комната, мягкий тёплый свет, предметная рекламная фотография, горизонтальный кадр, без текста.
Здесь почти каждое уточнение решает конкретную задачу.
Когда подробный промт только мешает
Обратная ситуация возникает, когда пользователь перегружает запрос противоречивыми требованиями.
Например:
Минималистичная фотография, очень детализированная, богатая декоративная композиция, строгий минимализм, множество объектов, чистый пустой фон...
Человек понимает, что эти требования конфликтуют.
Модели приходится искать компромисс.
Результат становится менее предсказуемым.
Поэтому полезнее решить заранее, что в изображении действительно важно, а чем можно пожертвовать.
Для фотографии и для иллюстрации нужны разные критерии
Фотореализм часто воспринимается как высшая форма качества AI-изображения, но это слишком узкий взгляд.
Для фотографии важны:
- естественные материалы;
- правдоподобный свет;
- анатомия;
- перспектива;
- поведение отражений;
- физическая логика сцены.
Для иллюстрации приоритеты могут быть совершенно другими:
- чистота формы;
- выразительный силуэт;
- ограниченная палитра;
- ритм элементов;
- стилистическая последовательность;
- возможность повторять персонажа.
Поэтому генератор, который побеждает в фотореализме, не обязательно будет лучшим инструментом для иллюстратора.
Отдельная задача — изображения товаров
В e-commerce художественная свобода модели зачастую нежелательна.
Если нейросеть изменила форму ручки чайника, количество кнопок на устройстве или фактуру материала, изображение может стать красивее, но перестанет правильно представлять товар.
Для обработки реальных товарных фотографий лучше выбирать инструменты, которые работают с существующим изображением, а не создают объект заново.
В каталоге IT’S NEW для этого есть, например, Daby AI, Claid AI и Photoroom.
Это хороший пример того, почему фраза «нужна нейросеть для картинок» недостаточно конкретна.
Генерация и редактирование — разные задачи
Стоит разделять два процесса.
Генерация отвечает на вопрос:
Как может выглядеть изображение, которого пока не существует?
Редактирование отвечает на другой:
Как изменить уже существующее изображение, сохранив всё остальное?
В первом случае допустима большая вариативность.
Во втором она становится проблемой.
Если пользователь просит заменить цвет дивана, он не хочет одновременно получить другое окно, новую комнату и человека в кадре.
Поэтому при выборе сервиса обязательно нужно смотреть, насколько хорошо он умеет выполнять локальные изменения.
Почему генератор изображений не всегда нужен вообще
Есть ещё один важный класс задач, которые ошибочно пытаются решать нейросетями.
Например, нужен:
- геометрический фон;
- абстрактная композиция;
- паттерн;
- SVG-сетка;
- декоративная анимация;
- повторяемая система форм.
Нейросеть способна нарисовать нечто похожее. Но такой результат часто оказывается обычным растровым изображением, где элементы нельзя независимо изменить.
Здесь гораздо логичнее процедурная генерация.
PlayLab: когда важнее контроль, чем искусственный интеллект
В PlayLab графика создаётся не из текстового описания, а из набора параметров.
Пользователь может менять форму, количество элементов, плотность, палитру, variation, движение и другие свойства композиции.
Главное отличие от AI становится особенно очевидным при повторной работе.
В нейросети пользователь говорит:
Сделай что-нибудь похожее, но немного иначе.
В процедурном генераторе можно сказать машине гораздо точнее:
Оставить эту композицию, увеличить сетку, уменьшить размер элементов и заменить палитру.
Это разные формы творчества.
Нейросеть предлагает интерпретацию.
Процедурный генератор исполняет систему правил.
Когда использовать PlayLab вместо AI
PlayLab имеет смысл открывать, если нужна:
- абстрактная графика для сайта;
- SVG;
- бесшовный паттерн;
- анимированный фон;
- геометрическая композиция;
- повторяемый визуальный стиль;
- точное управление параметрами.
Например, Modular работает с модульной геометрией, а Sampler позволяет строить повторяющиеся паттерны.
Для таких задач это зачастую рациональнее, чем несколько десятков раз просить AI сделать «так же, только геометричнее».
Как выбирать инструмент: начинать нужно не с названия нейросети
Перед открытием генератора попробуйте сформулировать задачу одним предложением.
Например:
Мне нужна атмосферная иллюстрация для обложки.
Тогда имеет смысл смотреть на модели с сильной визуальной стилизацией.
Или:
Мне нужен рекламный баннер, где должно быть правильно написано название продукта.
Здесь резко возрастает значение типографики.
Или:
У меня уже есть фотография товара, нужно заменить фон.
В таком случае первоначальная text-to-image генерация вообще не является основной задачей.
Или:
Мне нужен SVG-паттерн для сайта.
Тут может оказаться, что нейросеть вовсе не лучший инструмент.
Полезная схема выбора AI-генератора
Вместо бесконечного сравнения рейтингов можно последовательно задать себе несколько вопросов.
Первое: изображение создаётся с нуля?
Если да — нужен text-to-image генератор.
Если существует исходник — сначала стоит смотреть на инструменты image-to-image и AI-редактирования.
Второе: насколько важна точная композиция?
Если достаточно получить красивую интерпретацию, можно дать модели больше свободы.
Если расположение элементов критично, нужны референсы, эскизы, маски или более управляемый редактор.
Третье: будет ли внутри картинки текст?
Если да, способность работать с типографикой становится самостоятельным критерием выбора.
Четвёртое: нужен реализм или художественный стиль?
Эти задачи оцениваются по разным признакам.
Пятое: потребуется ли дальнейшее редактирование?
Если изображение должно пройти десять итераций, хороший редактор может оказаться ценнее самой эффектной первоначальной генерации.
Шестое: какой файл нужен в конце?
PNG, JPEG, SVG, прозрачный фон, изображение высокого разрешения — требования к результату тоже влияют на выбор инструмента.
Одна нейросеть на весь проект — не всегда хорошая идея
Профессиональный рабочий процесс всё чаще напоминает цепочку специализированных инструментов.
Например:
- Midjourney используется для поиска общей концепции;
- другой генератор создаёт более точную предметную сцену;
- Ideogram помогает с вариантом постера и текстом;
- Krea используется для визуальных исправлений;
- PlayLab создаёт отдельный геометрический фон;
- финальная сборка происходит в графическом редакторе.
Нет необходимости заставлять одну систему делать всё.
В традиционном дизайне никто не удивляется тому, что фотография обрабатывается в одном приложении, вектор рисуется в другом, а макет собирается в третьем.
С AI происходит примерно то же самое.
После генерации работа не заканчивается
Даже удачное AI-изображение перед публикацией стоит рассматривать как исходный материал.
Полезно проверить:
- анатомические ошибки;
- текст;
- фоновые детали;
- случайные логотипы и символы;
- перспективу;
- слишком мелкие элементы;
- реалистичность объекта;
- разрешение;
- формат файла;
- размер изображения.
Особенно внимательно нужно относиться к изображению, если оно используется не как декоративная иллюстрация, а как источник фактической информации.
Почему AI-картинку для сайта почти всегда стоит оптимизировать
Генераторы нередко создают изображение большего размера, чем требуется странице.
Если широкая картинка в статье отображается шириной 900 пикселей, нет смысла без причины загружать исходник на несколько тысяч пикселей и несколько мегабайт.
Перед публикацией изображение можно подготовить через конвертер изображений IT’S NEW: выбрать подходящий формат, уменьшить разрешение и сократить размер файла.
Если необходимо изменить композицию, пригодится онлайн-обрезка изображения.
Таким образом, генерация является только первым этапом:
идея → генерация → отбор → редактирование → кадрирование → оптимизация → публикация.
Стоит ли постоянно искать «лучшую нейросеть»
Рынок генеративной графики меняется слишком быстро, чтобы один сервис навсегда занял первое место.
Модели обновляются, инструменты редактирования становятся лучше, появляются новые способы задавать композицию и работать с референсами.
Поэтому полезнее научиться оценивать генераторы самостоятельно.
Возьмите три собственных типовых задачи и проверяйте новые инструменты именно на них.
Например:
- реалистичная предметная фотография;
- иллюстрация с несколькими конкретными объектами;
- постер с короткой надписью.
Одинаковые тесты довольно быстро покажут характер модели лучше, чем десятки чужих рейтингов.
Главный навык — не написание промтов, а постановка задачи
Генеративные модели сделали создание изображений доступнее, но не отменили необходимость понимать, чего именно хочется получить.
Человек, который умеет различать композицию, стиль, формат, назначение изображения и степень допустимой свободы, обычно получает более предсказуемый результат даже с простым промтом.
И наоборот: самая современная модель мало поможет, если задача сформулирована как «нарисуй что-нибудь красивое», а после генерации ожидается строго определённый коммерческий макет.
Поэтому выбирать стоит не абстрактно лучшую нейросеть, а инструмент, соответствующий конкретной стадии работы.
Для художественного поиска это может быть Midjourney. Для сложного text-to-image сценария — FLUX. Для типографики — Ideogram. Для итеративного визуального редактирования — Krea AI. Для процедурной SVG-графики и управляемых паттернов — PlayLab.
А другие генераторы и инструменты обработки можно найти в разделе нейросетей для изображений и графики на IT’S NEW.
