
Как нейросети превращают фото в видео и почему движение иногда выглядит неестественно

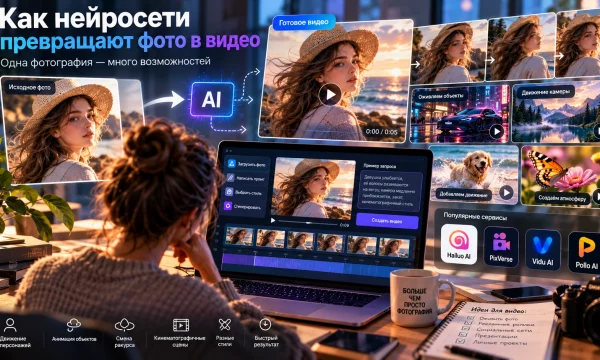
Оживить фотографию сегодня можно буквально за несколько минут: загрузить изображение, написать короткое описание движения и получить видеоролик, в котором человек поворачивает голову, волосы двигаются от ветра, вода начинает течь, а неподвижная камера будто совершает плавный проезд вокруг сцены.
На первый взгляд кажется, что нейросеть просто «добавляет движение» к готовой фотографии. На самом деле задача значительно сложнее. Исходное изображение содержит только один момент времени, а генератору приходится самостоятельно придумать всё, чего на фотографии нет: как объект выглядел за долю секунды до этого, что находится за его скрытой стороной, как должна двигаться камера и каким образом изменятся свет, тени, одежда, волосы и фон.
Именно поэтому AI-видео иногда выглядит удивительно реалистично, а иногда начинает буквально распадаться: лицо меняется от кадра к кадру, пальцы сливаются, предметы изгибаются, фон «течёт», а человек неожиданно приобретает новые детали. Чтобы получать более стабильный результат, полезно понимать, что именно пытается сделать модель.
Фотография содержит пространство, но не содержит времени
Обычная фотография фиксирует один момент. В ней можно определить положение человека, направление света, перспективу, объекты на заднем плане и множество других визуальных признаков.
Но из неё невозможно достоверно узнать, что произойдёт через секунду.
Если на фотографии человек стоит у окна, возможны десятки сценариев:
- он повернёт голову;
- посмотрит в камеру;
- улыбнётся;
- отойдёт от окна;
- останется неподвижным;
- камера приблизится к нему;
- камера начнёт двигаться вокруг;
- изменится только свет.
Нейросеть должна выбрать один из возможных вариантов и построить последовательность промежуточных кадров.
Поэтому image-to-video — это не анимация фотографии в классическом смысле. Это генерация вероятного продолжения сцены на основе одного изображения.
Откуда нейросеть знает, как должен двигаться объект
Видео-модели обучаются на большом количестве последовательностей, где объекты показаны в движении. Благодаря этому система постепенно изучает статистические закономерности реального мира.
Например, она узнаёт, что:
- при повороте головы меняется положение глаз, носа и ушей;
- волосы реагируют на ветер не так, как твёрдые предметы;
- отражение на воде меняется вместе с поверхностью;
- при движении камеры близкие объекты смещаются быстрее дальних;
- ткань складывается и деформируется;
- тени должны следовать за движением объекта.
Но модель не рассчитывает физику сцены так же, как полноценный 3D-движок. Она создаёт визуально вероятную последовательность.
Этой разницей и объясняется значительная часть странных AI-видео.
Почему фотография начинает «оживать» даже без подробного промта
Если загрузить изображение в сервис вроде Hailuo AI, Vidu AI или другого image-to-video генератора и почти ничего не написать, модель всё равно может создать движение.
Она анализирует изображение и выбирает наиболее вероятную динамику.
Портрет может получить:
- лёгкое движение головы;
- моргание;
- дыхание;
- движение волос;
- изменение выражения лица.
Пейзаж — другой тип динамики:
- движение облаков;
- ветер;
- волнение воды;
- изменение света;
- плавный проезд камеры.
Это выглядит впечатляюще именно потому, что система сама распознаёт характер сцены.
Но автоматическое решение модели не обязательно совпадает с замыслом пользователя.
Промт для видео описывает не картинку, а изменение картинки
Это принципиальное отличие от генерации изображений.
При text-to-image запрос обычно отвечает на вопрос:
Что должно находиться в кадре?
При image-to-video большая часть ответа уже есть на исходной фотографии.
Поэтому полезнее описывать:
Что должно произойти с тем, что уже находится в кадре?
Например, вместо:
Девушка стоит на берегу моря.
лучше написать:
Девушка медленно поворачивает голову к морю. Волосы слегка двигаются от ветра. Волны спокойно подходят к берегу. Камера остаётся почти неподвижной.
Во втором случае генератор получает инструкцию именно о времени и движении.
Почему слишком много движения ухудшает результат
Пользователь естественно хочет получить максимум от короткого ролика.
Отсюда появляются запросы вроде:
Человек встаёт, разворачивается, идёт к машине, открывает дверь, садится, машина начинает движение, камера летит вверх.
Для одного небольшого image-to-video клипа это чрезвычайно сложная задача.
На каждом этапе модели приходится создавать новую информацию, которой не было в исходнике.
Если человек стоит лицом к камере, но должен развернуться, нейросеть должна придумать:
- затылок;
- заднюю часть одежды;
- форму тела с другого ракурса;
- пространство, которое раньше было закрыто человеком.
Чем больше такой новой информации появляется во времени, тем выше риск ошибок.
Главное правило стабильного image-to-video: небольшое движение
Для большинства фотографий хороший первый тест выглядит очень скромно.
Например:
Лёгкий ветер двигает волосы и одежду. Человек немного улыбается. Камера медленно приближается.
Или:
Вода плавно движется, листья слегка качаются от ветра. Медленный cinematic push-in.
В таких сценариях значительная часть исходного изображения может оставаться неизменной.
Это облегчает задачу модели и обычно помогает сохранить идентичность объектов.
Почему лицо может меняться от кадра к кадру
Человеческое лицо — один из самых чувствительных объектов для генеративного видео.
Даже очень небольшое изменение сразу заметно зрителю.
Если форма дерева чуть отличается в соседних кадрах, большинство людей этого не замечает. Если изменилось расстояние между глазами или форма носа, эффект становится очевидным.
Проблема особенно усиливается при:
- сильном повороте головы;
- резком приближении камеры;
- изменении мимики;
- частичном закрытии лица;
- плохом исходном разрешении;
- необычном освещении;
- профильных ракурсах.
Почему портрет в три четверти иногда сложнее фронтального
Если человек смотрит прямо в камеру, модель получает много симметричной информации о лице.
Если лицо находится в профиль, значительная часть его структуры скрыта.
Когда такой человек начинает поворачиваться, системе приходится буквально достраивать невидимую сторону.
Именно здесь могут появиться:
- другая форма носа;
- изменение причёски;
- другое ухо;
- несовпадение линии подбородка;
- изменение возраста или выражения.
Поэтому исходное изображение само по себе очень сильно влияет на качество будущего видео.
Хорошая исходная фотография важнее длинного промта
Перед генерацией стоит посмотреть на изображение не как на красивую фотографию, а как на исходные данные для модели.
Удобнее всего работают кадры, где:
- главный объект хорошо отделён от фона;
- лицо достаточно крупное;
- важные части тела не обрезаны случайным образом;
- нет большого количества пересекающихся предметов;
- изображение достаточно чёткое;
- поза понятна;
- освещение не скрывает половину объекта.
Сложная художественная фотография с множеством отражений может выглядеть прекрасно для человека, но оказаться намного труднее для видео-модели.
Почему руки остаются проблемной областью
Руки обладают огромным количеством возможных положений.
Каждый палец может двигаться почти независимо, кисть поворачивается в пространстве, пальцы перекрывают друг друга, а объект в руке создаёт дополнительные ограничения.
В статичном изображении система должна решить эту задачу один раз.
В видео правильная структура должна сохраняться на протяжении десятков последовательных кадров.
Поэтому сценарий:
Человек спокойно смотрит в камеру.
обычно проще, чем:
Человек берёт чашку, подносит её к губам и делает глоток.
Во втором случае появляется сложное взаимодействие лица, пальцев, чашки и пространства.
Почему предметы иногда плавятся и меняют форму
Типичный AI-артефакт — постепенное изменение объекта.
Например, у автомобиля:
- исчезает фара;
- меняется колесо;
- дверь превращается в часть кузова;
- логотип меняет форму.
Это происходит потому, что модель должна сохранять объект согласованным во времени.
Каждый следующий кадр одновременно должен:
- следовать предыдущему;
- соответствовать исходному изображению;
- реализовывать заданное движение;
- оставаться визуально правдоподобным.
Чем сложнее объект, тем труднее удержать все эти ограничения одновременно.
Логотипы и текст особенно плохо переносят движение
Предположим, на фотографии находится футболка с крупной надписью.
Если человек начинает поворачиваться, ткань изменяет форму. Надпись тоже должна деформироваться геометрически правильным образом.
Для генеративной модели это сложная задача.
Поэтому буквы могут:
- меняться;
- исчезать;
- сливаться;
- превращаться в похожие символы.
То же касается упаковки товара и фирменных логотипов.
Если бренд должен оставаться абсолютно точным, генеративное видео нужно проверять покадрово.
Камера тоже может быть объектом генерации
Один из самых впечатляющих эффектов image-to-video — виртуальное движение камеры.
Из одной фотографии можно получить ощущение:
- приближения;
- отъезда;
- панорамирования;
- движения вокруг объекта;
- подъёма камеры;
- ручной камеры.
Но настоящей трёхмерной сцены у модели изначально нет.
Когда камера начинает смещаться, приходится предполагать, как выглядит пространство с нового угла.
Почему небольшой zoom работает лучше облёта вокруг объекта
При простом приближении большая часть уже видимой сцены сохраняется.
При движении камеры в сторону начинают появляться области, которых вообще не было на исходной фотографии.
Например, если камера обходит автомобиль, нужно показать его боковую или заднюю часть.
Эта информация отсутствует в исходнике.
Модель вынуждена её придумать.
Именно поэтому сложное движение камеры повышает вероятность визуальной нестабильности.
Что такое параллакс и почему он делает AI-видео убедительным
Когда настоящая камера перемещается в пространстве, объекты на разных расстояниях двигаются относительно кадра с разной скоростью.
Близкий объект меняет положение сильнее, далёкий — меньше.
Это явление называется параллаксом.
Даже небольшой правильно сымитированный параллакс создаёт сильное ощущение глубины.
Именно поэтому простая фотография пейзажа может неожиданно стать похожей на настоящий видеокадр, если передний план слегка смещается относительно гор на горизонте.
Hailuo AI: выразительное движение из одного кадра
Hailuo AI относится к сервисам, через которые можно работать с генеративным видео и превращать статичные сцены в короткие динамические фрагменты.
Для таких инструментов особенно удачны изображения, где уже существует визуально понятное направление движения:
- человек с развевающимися волосами;
- автомобиль на дороге;
- лодка на воде;
- ткань;
- облака;
- пейзаж с выраженной глубиной.
В этих сценах модели проще предположить естественную динамику.
PixVerse: когда нужны быстрые визуальные эксперименты
PixVerse позволяет работать как с текстовыми сценариями, так и с исходными изображениями.
Для творческой работы это удобно тем, что одну фотографию можно использовать как основу сразу для нескольких вариантов движения.
Например, один и тот же портрет можно проверить с:
- медленным приближением;
- движением волос;
- лёгким поворотом головы;
- изменением освещения.
Вместо попытки сразу получить идеальный ролик полезнее искать наиболее стабильный тип движения.
Vidu AI: референс важнее абстрактного описания
Vidu AI интересен в том числе сценариями, где исходное изображение задаёт визуальное направление будущего видео.
И это хорошо иллюстрирует общее правило генеративного видео:
чем больше полезной информации уже содержится в исходнике, тем меньше модели приходится придумывать.
Если нужен конкретный персонаж, одежда, интерьер или продукт, хорошая исходная картинка зачастую гораздо ценнее длинного словесного описания.
Pollo AI и агрегаторы видео-моделей
Pollo AI представляет другой подход — доступ к генерации видео через платформу, которая объединяет различные инструменты и сценарии.
Подобные сервисы полезны тем, что пользователь может тестировать разные подходы к одной задаче, не перестраивая весь рабочий процесс.
Это особенно важно в видео, потому что поведение моделей различается заметнее, чем может показаться по их рекламным демонстрациям.
Почему нельзя оценивать видео-модель по одному удачному ролику
Галереи AI-сервисов обычно показывают лучшие результаты.
Это логично: производитель хочет продемонстрировать возможности технологии.
Но пользователю важен другой показатель — повторяемость.
Если из десяти генераций одна выглядит превосходно, а девять содержат серьёзные ошибки, такой инструмент может быть неудобен для ежедневной работы.
Поэтому модель лучше проверять на нескольких собственных сценах:
- портрет;
- предмет;
- пейзаж;
- человек в полный рост;
- объект с текстом;
- сложное движение.
Движение объекта или движение камеры?
Перед генерацией полезно определить, что именно должно создавать динамику.
Первый вариант — объект движется, камера остаётся почти неподвижной.
Например:
Ветер плавно двигает листья, вода течёт, камера статична.
Второй — объект почти неподвижен, движется камера:
Персонаж стоит неподвижно, камера медленно приближается.
Оба сценария обычно проще, чем одновременное активное движение объекта и камеры.
Почему стоит начинать с короткого клипа
Каждая дополнительная секунда требует сохранять согласованность сцены дольше.
Небольшая ошибка, появившаяся в начале, может усиливаться по мере продолжения видео.
Например:
- немного изменяется лицо;
- в следующем кадре модель опирается уже на изменённый вариант;
- отклонение усиливается;
- к концу ролика человек становится заметно другим.
Поэтому для сложных сцен лучше сначала добиться хорошего короткого движения.
Иногда лучше собрать ролик из нескольких генераций
Вместо одного длинного промта:
Человек поворачивается, подходит к окну, открывает его, смотрит наружу, камера отъезжает.
можно разделить сцену.
Кадр 1
Человек слегка поворачивается к окну.
Кадр 2
Человек стоит у окна и смотрит наружу.
Кадр 3
Камера медленно отъезжает от окна.
Затем фрагменты собираются в видеоредакторе.
Такой подход требует больше работы, но даёт больше контроля.
Как писать промт для image-to-video
Вместо описания всей сцены удобно использовать четыре элемента:
движение объекта + движение среды + движение камеры + темп.
Например:
Мужчина медленно поворачивает голову вправо. Его куртка слегка двигается от ветра. На заднем плане плавно движутся ветви деревьев. Камера делает очень медленный push-in. Естественное спокойное движение.
В этом запросе почти нет описания внешности человека, потому что она уже задана фотографией.
Не нужно заставлять всё в кадре двигаться
Одна из ошибок — попытка анимировать каждый элемент.
Настоящее видео часто содержит множество практически неподвижных объектов.
Если одновременно движутся:
- камера;
- фон;
- волосы;
- руки;
- голова;
- одежда;
- освещение;
зрителю сложнее воспринимать сцену, а модели сложнее сохранять её структуру.
Иногда почти незаметное движение выглядит реалистичнее масштабной анимации.
Как оживлять старые фотографии
Для архивной фотографии стратегия несколько отличается.
Главная задача обычно состоит не в создании эффектного видео, а в сохранении человека.
Поэтому движение лучше ограничить:
- морганием;
- лёгкой улыбкой;
- небольшим поворотом;
- естественным движением головы.
Сильный поворот или изменение позы заставляет модель придумывать слишком много скрытых деталей и повышает вероятность того, что лицо перестанет быть похожим на исходное.
В каталоге IT’S NEW для работы со старыми фотографиями представлен, например, Deep Nostalgia, специализирующийся именно на анимации портретов.
Видео из фотографии товара: отдельная проблема
В рекламном ролике нельзя позволить генератору свободно менять продукт.
Если нейросеть превратила пять кнопок устройства в четыре или изменила форму упаковки, результат уже нельзя считать корректной демонстрацией товара.
Поэтому в product video движение лучше строить вокруг продукта, а не внутри него.
Например:
- медленный проезд камеры;
- движение света;
- частицы на фоне;
- небольшое вращение при хорошо заданной форме;
- движение окружающих декоративных элементов.
Сам продукт желательно менять как можно меньше.
Перед генерацией стоит подготовить исходную фотографию
Иногда проблема будущего видео находится не в модели, а в исходнике.
Лишний объект у края кадра, слишком большое пустое пространство или неправильное соотношение сторон заставляют генератор решать дополнительные задачи.
Изображение можно заранее подготовить через онлайн-обрезку IT’S NEW.
Если исходник имеет неподходящий формат или слишком большой размер, можно использовать конвертер изображений.
Такая подготовка особенно полезна, когда видео должно иметь конкретный вертикальный или горизонтальный формат.
Вертикальное и горизонтальное видео лучше планировать заранее
Если конечный ролик предназначен для вертикального формата, лучше ещё до генерации подготовить вертикальный исходник.
Иначе сервису приходится либо обрезать изображение, либо дорисовывать пространство сверху и снизу.
То же относится к широкому видео.
Правильная последовательность обычно выглядит так:
выбрать конечный формат → подготовить изображение → проверить композицию → только потом генерировать движение.
Почему апскейл лучше делать после генерации
Не всегда есть смысл начинать работу с огромного изображения.
На этапе поиска движения важнее стабильность композиции.
Если результат не подходит, дополнительное качество исходника не спасёт сцену.
Рациональнее сначала найти хороший вариант движения, а уже затем увеличивать разрешение финального материала или использовать более качественный режим экспорта.
AI-видео пока лучше воспринимать как генерацию дублей
В обычной съёмке режиссёр редко ожидает, что первый дубль окажется идеальным.
С генеративным видео полезно мыслить аналогично.
Промт определяет направление, но каждая генерация может немного отличаться.
Поэтому вместо бесконечного усложнения запроса часто эффективнее создать несколько дублей с одинаковой базовой идеей и выбрать самый стабильный.
Как понять, что генерацию лучше остановить
Есть риск потратить десятки попыток на сцену, которая изначально слишком сложна.
Если постоянно возникают одни и те же проблемы — например, рука каждый раз деформируется при определённом движении — стоит не продолжать генерацию, а изменить сцену.
Можно:
- уменьшить движение;
- изменить кадрирование;
- скрыть проблемную область;
- поменять исходную фотографию;
- разделить действие на несколько кадров;
- выбрать другую модель.
Это часто эффективнее, чем пытаться победить ограничение одним только промтом.
Как выбрать сервис для фото в видео
Начинать лучше не с вопроса «какая нейросеть сейчас лучшая», а с типа материала.
Портрет
Главный критерий — сохранение лица и естественная мимика. Лучше небольшие движения.
Пейзаж
Можно позволить больше движения окружающей среды и камеры.
Товар
Критична геометрическая стабильность продукта.
Иллюстрация
Можно экспериментировать сильнее, потому что физическая достоверность часто менее важна.
Старая фотография
Главное — сохранить личность человека, а не создать эффектный ролик.
Несколько моделей лучше одной универсальной
Как и с генерацией изображений, разные видео-модели могут по-разному интерпретировать одну сцену.
Поэтому имеет смысл сравнивать Hailuo AI, Vidu AI, PixVerse, Pollo AI и другие решения не по рекламным роликам, а на собственном изображении.
Один генератор может лучше сохранить лицо, другой — создать более эффектное движение камеры, третий — интереснее работать с иллюстрацией.
Главное — не заставлять нейросеть придумывать лишнее
Самый полезный принцип image-to-video можно сформулировать довольно просто:
чем меньше неизвестной информации приходится создавать модели, тем легче получить стабильный результат.
Если исходная фотография хорошая, объект хорошо виден, движение небольшое, камера не совершает невозможных манёвров, а промт описывает именно изменение сцены, шансы на удачный ролик значительно возрастают.
AI-видео производит сильное впечатление именно потому, что создаёт время там, где его раньше не существовало. Но вместе с движением модели приходится придумывать скрытую геометрию, физику и новые ракурсы.
Поэтому лучший результат обычно получается не тогда, когда нейросети дают максимум свободы, а когда человек заранее решает, что действительно должно измениться, а что должно остаться неизменным.
Другие инструменты для генерации и обработки роликов собраны в разделе нейросетей для видео на IT’S NEW. В каталоге также можно подобрать сервисы для озвучки, субтитров, обработки изображений и подготовки исходных материалов.
