
Как выбрать нейросеть: разбор 20 моделей по 14 задачам с расчётом стоимости результата

Автор исследования в Leiman Lab собрал AI Index — интерактивный справочник из 20 моделей с подбором под 14 рабочих сценариев, сравнением возможностей, историей изменений и калькулятором стоимости результата. Материал подготовлен 4 ноября 2026 года; характеристики, условия доступа и позиции в рейтингах могут меняться.
Проблема выбора ИИ в 2026 году
28 октября Google представила Gemini 4 Carbon. Модель заняла первое место в обновлённом рейтинге Artificial Analysis, набрав 59 баллов. Следом расположились Claude Opus 5.5 с 58 баллами и GPT-6 Astra с 57. Однако на момент релиза Carbon была доступна лишь ограниченному кругу специалистов по кибербезопасности. Получается, модель может возглавлять мировой рейтинг и при этом оставаться бесполезной для большинства пользователей просто потому, что работать с ней пока нельзя. Эта ситуация точно описывает главную сложность выбора инструментов в 2026 году: высокая позиция в таблице не гарантирует применимость в реальных задачах.
Методология подбора: от универсальных рейтингов к задачевой декомпозиции
Artificial Analysis в октябре обновила методологию Intelligence Index до версии 5.0. Теперь в ней девять испытаний, охватывающих профессиональные задачи, программирование, науку и общие интеллектуальные способности. Разница между лидерами невелика, но гораздо интереснее смотреть на отдельные задания: одна модель сильнее в коде, другая в исследовании, третья в автоматизации. Помимо качества генерации, выбор определяется стоимостью, доступностью, скоростью и возможностью встроить систему в собственный процесс. Поэтому автор предлагает начинать подбор с конкретной задачи, а не с места в общем рейтинге.
Тексты и исследования: пошаговый подход
Подготовка статьи на сложную тему включает минимум три операции: поиск источников, изучение собранных материалов и построение собственной аргументации. Для первой стадии автор рекомендует Perplexity — он помогает быстро собрать отправные ссылки и определить, какие оригинальные публикации стоит прочитать. Для работы с большим набором уже найденных PDF и заметок удобен NotebookLM: исследование организуется вокруг конкретного корпуса документов. Для построения аргументации, критики выводов и редактуры стоит сравнить ChatGPT и Claude. Даже сильная модель способна придумать ссылку, неверно интерпретировать исследование или воспроизвести утверждение из вторичного источника, поэтому финальная проверка фактов остаётся отдельной операцией. Автор также отмечает проблему авторского стиля: чем лучше система строит гладкие предложения, тем проще ей стереть индивидуальную речь человека.
Генерация изображений: разные инструменты для разных этапов
Здесь разделены художественный поиск и производство утверждённого изображения. Midjourney V8.2 имеет смысл рассматривать для визуальных исследований, поиска стилистики и неожиданных композиционных решений — в документации разработчики отмечают развитие персонализации и художественных возможностей. GPT Image 2.5 Sunburst ориентирована на точное редактирование: важно, когда изображение уже утверждено, а изменить требуется только отдельную деталь. Ideogram 4.5 предлагает специализированное редактирование выбранной области. Recraft V4.1 Vector интересен генерацией редактируемых векторных файлов SVG. Общий рейтинг красоты мало помогает; для рекламного производства важно считать, сколько попыток требуется, чтобы внести одну точную правку и сохранить всё остальное.
Видеогенерация: три типа задач и актуальные лидеры
С видеогенерацией проблема ещё заметнее. Создать сцену по тексту, анимировать готовое изображение и изменить уже существующий ролик — три существенно разных процесса. По данным Artificial Analysis Video Arena на 4 ноября 2026 года в категории Text-to-Video с аудио лидировала Wan 3.0. Если исходные кадры уже готовы и нужно управлять их анимацией, имеет смысл изучить Seedance 2.5: ByteDance заявляет поддержку мультимодальных референсов и генерации фрагментов до 30 секунд. Для работы с короткими управляемыми сценами стоит также рассмотреть инструменты Runway. В производстве качество отдельного удачного дубля не определяет пригодность модели — важны стабильность персонажей, предсказуемость движения, сохранение референсов и стоимость исправлений. Ситуация усложняется закрытием сервисов: Sora прекратила работу как приложение и веб-сервис 26 апреля 2026 года, а её API был отключён 24 сентября. Поэтому старые сравнительные обзоры нужно проверять заново.
Аудио и музыка: лицензии и ограничения экспорта
Suno выпустила семейство V6 в сентябре 2026 года: обычную V6 для более управляемой генерации, экспериментальную V6 Wild и ускоренную V6 Mini для эскизов. Для синтеза речи и озвучивания стоит отдельно изучать решения ElevenLabs. Но у музыкальных сервисов есть ограничение, которое легко пропустить при сравнении звучания. Согласно актуальной документации Suno, тариф Pro предусматривает 20 скачиваний в месяц, Premier — 60. У Udio скачивание аудио, видео и отдельных дорожек отключено. Это влияет на возможность использовать материал в коммерческой работе. Создать трек, скачать его, получить необходимые права и передать заказчику — разные условия, их нужно проверять до начала производства.
Экономика результата: калькулятор себестоимости
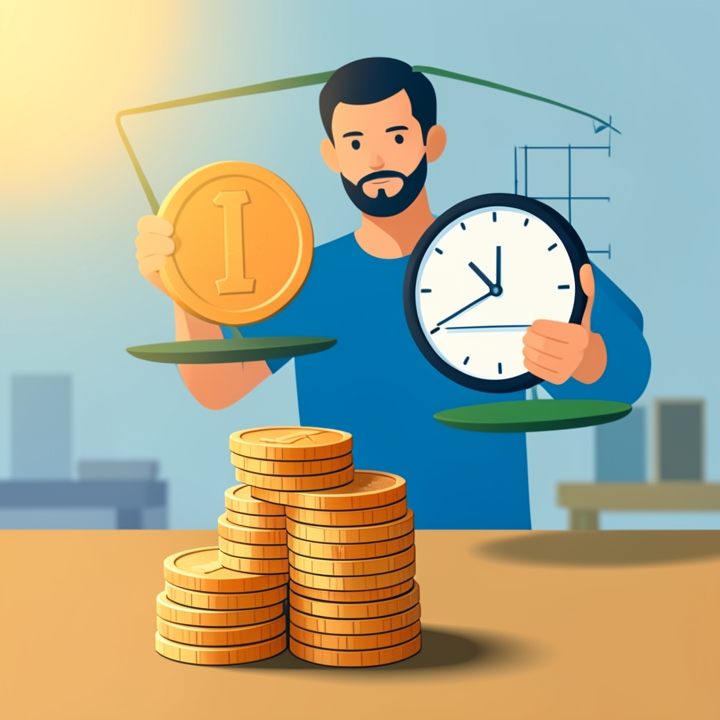
Автор приводит пример: видеогенератор, у которого одна попытка обходится в $1,50. Допустим, только 25% результатов подходят для использования. В среднем придётся сделать четыре попытки. Если оценка и корректировка каждой занимают пять минут, а час работы человека стоит $25, то ожидаемая себестоимость одного удачного результата составит $14,33 вместо $1,50 — и это без дополнительных расходов на монтаж, цветокоррекцию и звук. Именно поэтому в AI Index добавлен калькулятор стоимости результата, где можно менять цену генерации, процент удачных попыток, время работы оператора и его почасовую ставку. Для производства это иногда полезнее очередного списка «10 лучших нейросетей».
Пять выводов для производственного использования ИИ
- Универсальный рейтинг помогает сузить список кандидатов. Окончательный выбор зависит от задачи и условий доступа.
- В творческой работе способность системы сохранять уже утверждённые детали нередко важнее качества первой генерации.
- Стоимость следует рассчитывать по пригодным результатам с учётом человеческой работы. Цена одной попытки может сильно вводить в заблуждение.
- Лицензии, ограничения экспорта и доступность API способны изменить решение даже при превосходном качестве генерации.
- Собственный рейтинг имеет смысл строить на одинаковых заданиях, многократных попытках и слепой оценке. По одному красивому примеру определить лучшую модель невозможно.
Инструментарий AI Index
В интерактивной версии можно выбрать одну из 14 задач, посмотреть подходящие инструменты из каталога 20 моделей, сравнить две системы, рассчитать себестоимость результата и изучить изменения рынка. Для следующего этапа подготовлены четыре протокола испытаний: работа с источниками, точная правка изображений, анимация короткой сцены и генерация музыкального фрагмента. Первые результаты собственных тестов ещё предстоит получить; до этого рекомендации оставляются открытыми для пересмотра.
Вопросы и ответы
Почему лидер рейтинга Gemini 4 Carbon может быть бесполезен для большинства пользователей?
На момент релиза 28 октября модель была доступна только ограниченному кругу специалистов по кибербезопасности, поэтому высокая позиция в Artificial Analysis не означает открытый доступ.
Какие инструменты автор рекомендует для этапов работы с текстом?
Perplexity — для поиска источников, NotebookLM — для работы с корпусом документов, ChatGPT и Claude — для аргументации и редактуры, а проверку фактов выносит в отдельную операцию.
Как рассчитывается реальная стоимость результата генерации?
С учётом цены одной попытки, процента брака, времени оператора на оценку и его почасовой ставки. Пример: при $1,50 за попытку, 25% успеха, 5 минут на проверку и ставке $25/час себестоимость пригодного результата — $14,33.